Mmaudio
Artículo · Página web · Modelos · Demostración · Colab · Replicate
Dominando el entrenamiento conjunto multimodal para la síntesis de audio de alta calidad a partir de vídeo
Ho Kei Cheng, Masato Ishii, Akio Hayakawa, Takashi Shibuya, Alexander Schwing, Yuki Mitsufuji
Universidad de Illinois Urbana-Champaign, Sony AI y Sony Group Corporation
CVPR 2025
Destacado
mmaudio genera audio sincronizado a partir de vídeo y texto. Su idea central es el entrenamiento conjunto multimodal con una amplia variedad de datos audiovisuales y de audio y texto, combinado con un módulo de sincronización que ajusta el sonido generado al movimiento y al tiempo de cada fotograma.
Prueba una de las indicaciones de arriba o explora los ejemplos de abajo:
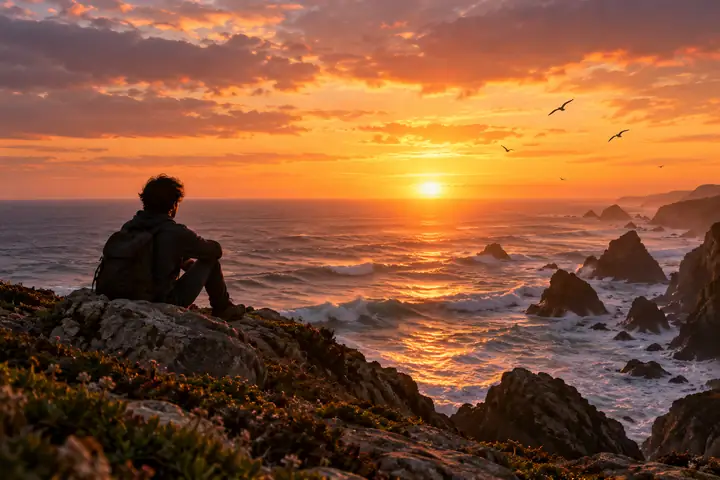
Escena oceánica al estilo de Sora
Sonido ambiental sincronizado
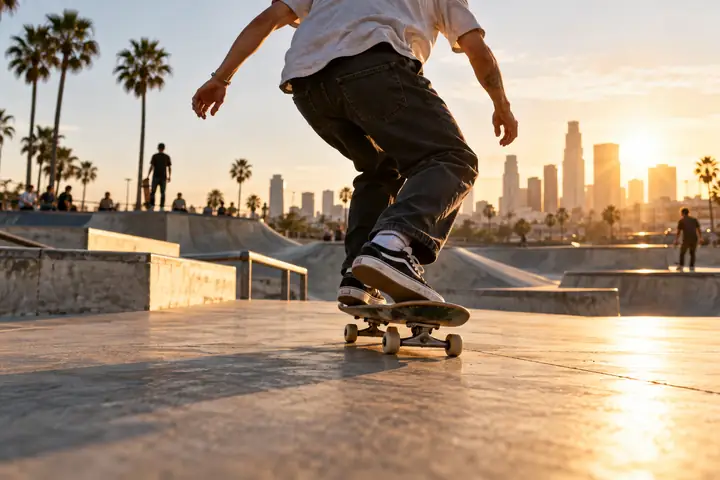
Secuencia de skate al estilo de Veo
Impactos sincronizados con el movimiento
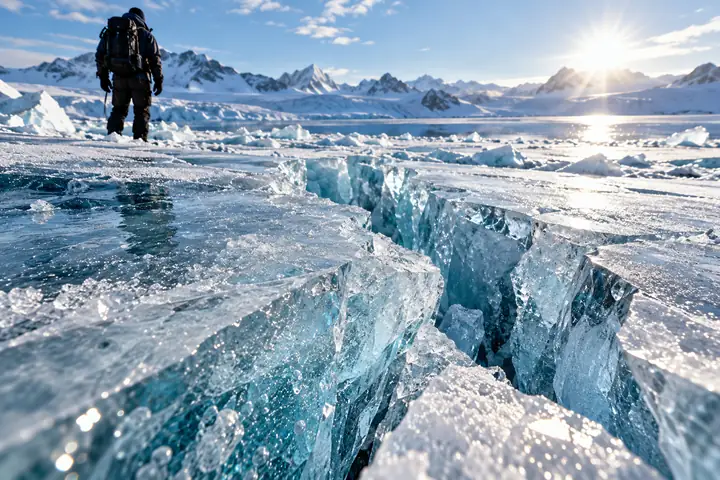
Primer plano de un material
Diseño sonoro basado en texturas
Instalación
Hemos probado mmaudio en entornos Ubuntu con hardware moderno compatible con CUDA.
Requisitos previos
Recomendamos usar miniforge entorno.
- Python 3.9+
- PyTorch 2.5.1+ con los paquetes torchvision y torchaudio correspondientes a su versión de CUDA.
1. Instale los paquetes necesarios si es preciso:
También pueden funcionar otras versiones de CUDA si son compatibles con su GPU y controlador.
2. Clone el repositorio:
3. Instale mmaudio con pip:
pip install -e .
Los archivos del modelo se descargan automáticamente al ejecutar el script de demostración. Las sumas de comprobación y los detalles del modelo se incluyen en la documentación del repositorio.
Demostración
De forma predeterminada, los scripts utilizan el large_44k_v2 modelo. En nuestros experimentos, la inferencia utiliza alrededor de 6GB de memoria de GPU en modo de 16 bits, lo que es compatible con muchas GPU modernas.
Interfaz de línea de comandos
Con demo.py:
El audio se escribe en formato .flac y el video reconstruido se escribe en formato .mp4 en ./outputOmitir --video para la síntesis de texto a audio.
Interfaz de Gradio
La interfaz admite la síntesis de video a audio y de texto a audio. También está disponible el procesamiento experimental de imagen a audio mediante la duplicación de una imagen en una secuencia de video. El puerto predeterminado es 7860.
Preguntas frecuentes
- Procesamiento de video. Los videos de mayor resolución tardan más en codificarse y decodificarse, pero no necesariamente mejoran la calidad de salida. El codificador CLIP cambia el tamaño de los fotogramas a 384×384 píxeles, mientras que Synchformer cambia el tamaño del borde más corto a 224 píxeles y aplica un recorte centrado.
- Velocidades de fotogramas. CLIP funciona a 8 FPS y Synchformer a 25 FPS. La conversión de la velocidad de fotogramas se realiza mediante el lector de video, utilizando duplicación cuando la velocidad de fotogramas de entrada es inferior a la requerida.
- Casos de fallo. Al igual que con la mayoría de los modelos generativos, pueden producirse fallos y las razones no siempre son evidentes. Los modos de fallo conocidos están documentados en los materiales del proyecto.
- Variaciones de rendimiento. El hardware, los backends de video, la precisión de inferencia, los tamaños de lote, los ajustes de compilación y las semillas aleatorias pueden producir diferencias sutiles entre ejecuciones.
Limitaciones conocidas
- En ocasiones, el modelo puede generar sonidos ininteligibles similares al habla humana.
- En ocasiones, el modelo puede generar música de fondo sin entrenamiento musical explícito.
- El modelo puede tener dificultades con conceptos desconocidos y descripciones de acciones detalladas.
Estas limitaciones pueden abordarse mediante datos de entrenamiento de mayor calidad y más diversos.
Entrenamiento
Consulta TRAINING.md para obtener detalles sobre la preparación de datos, el entrenamiento distribuido y la configuración.
Evaluación
Consulta EVAL.md para obtener información sobre la configuración de las pruebas comparativas y los scripts de evaluación del inicio.
Conjuntos de datos de entrenamiento
mmaudio se entrenó con varios conjuntos de datos, incluidos AudioSet, Freesound, VGGSound, AudioCaps y WavCaps. Estos conjuntos de datos tienen sus propias licencias y condiciones de uso. Es posible que los modelos preentrenados no sean adecuados para todos los casos de uso comerciales.
Registros de actualizaciones
- 2025-03-09: Se cargaron archivos TSV corregidos.
- 2025-02-27: Se deshabilitó GradScaler de forma predeterminada para mejorar la estabilidad del entrenamiento.
- 2024-12-23: Se añadieron scripts de entrenamiento y evaluación por lotes.
- 2024-12-14: Se reemplazó el lector de fotogramas por PyAV y se almacenaron en caché los fotogramas durante la reconstrucción.
- 2024-12-13: Se mejoró la extracción de características de CLIP y Sync con un multiplicador del tamaño del lote y se eliminó el codificador VAE no utilizado durante la inferencia.
- 2024-12-11: Se reemplazó el lector de la tasa de fotogramas para lograr una reconstrucción más fiable en distintos entornos de GPU alojados.
Cita
title={{MMAudio}: Taming Multimodal Joint Training for High-Quality Video-to-Audio Synthesis},
author={Cheng, Ho Kei and Ishii, Masato and Hayakawa, Akio and Shibuya, Takashi and Schwing, Alexander and Mitsufuji, Yuki},
booktitle={CVPR},
year={2025}
}
Repositorios relevantes
- av-benchmark para obtener resultados de evaluación comparativa.
Licencia
- El código se distribuye bajo la licencia MIT.
- Los checkpoints se distribuyen bajo la licencia CC-BY-NC 4.0.
Descargo de responsabilidad
No tenemos ninguna afiliación ni conocimiento sobre la parte responsable del dominio “mmaudio.net”.
Agradecimientos
Muchas gracias a:
- Make-An-Audio 2 para el modelo BigVGAN preentrenado de 16kHz y la arquitectura VAE.
- BigVGAN
- Synchformer
- EDM2 para la arquitectura de red VAE con preservación de magnitud.